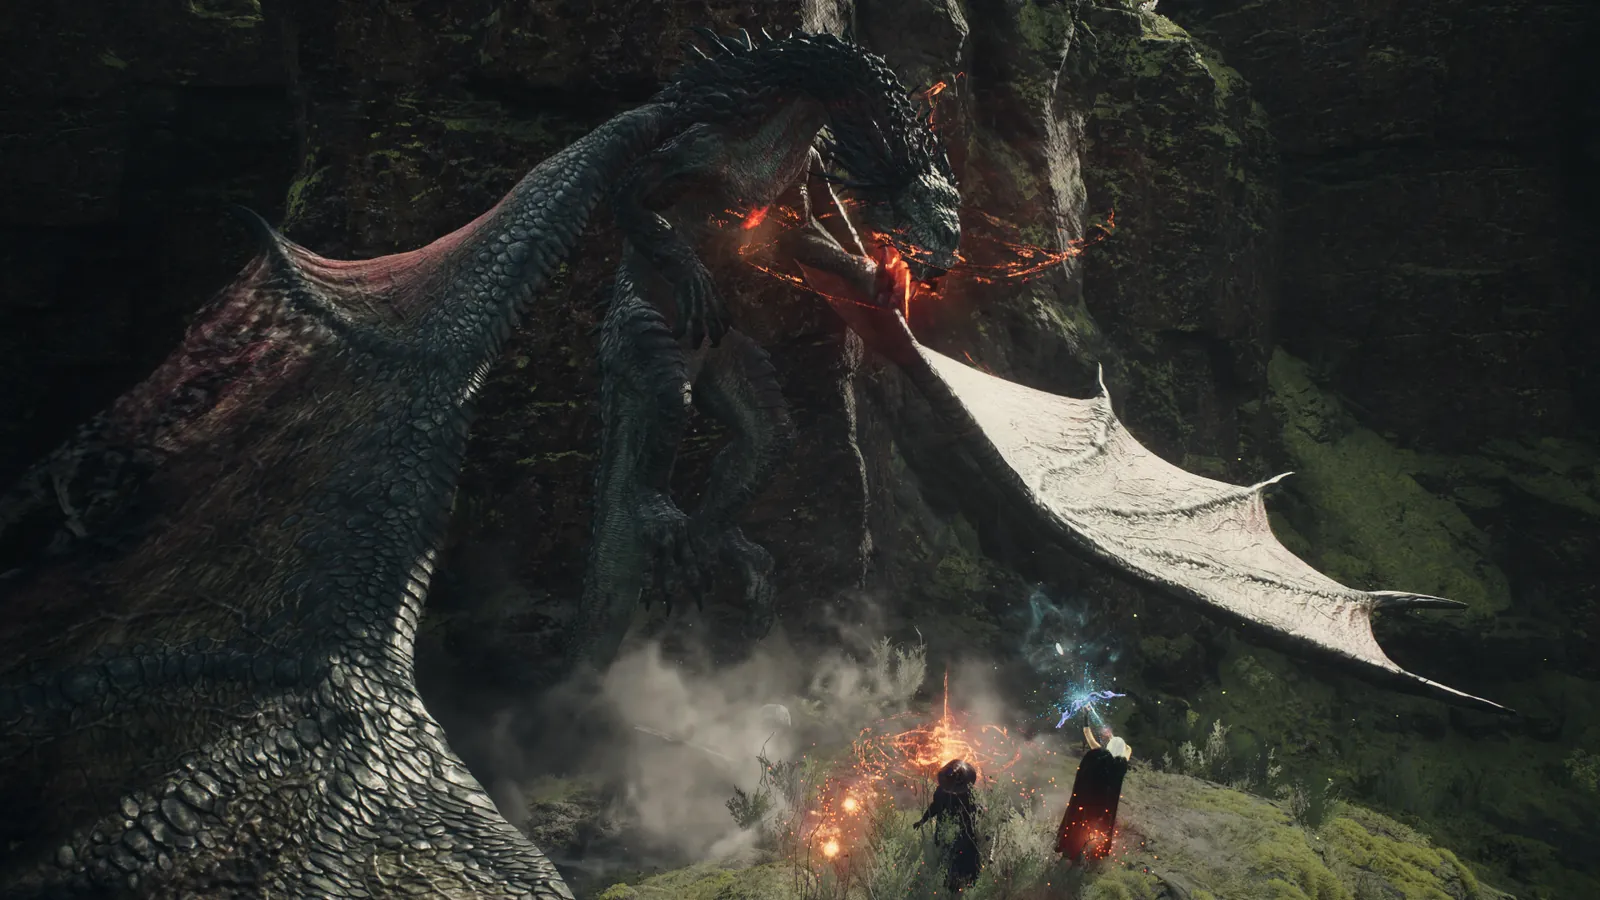
まず、敵を見るだけで難しい
『ドラゴンズドグマ2』には、一般的なアクションゲームのような強力なロックオン機能がない。
プレイヤーは右スティックでカメラを動かしながら、自分で敵を画面内に捉え続ける必要がある。人間なら普通にやっている操作だ。
でも、これをAIにやらせようとすると、いきなり難易度が跳ね上がる。
まず画面を見て「これはドレイクだ」と認識する。次に、ドレイクが画面のどこにいるのかを把握する。敵が右に動けばカメラを右へ。左へ飛べば左へ。画面外に出そうなら追いかける。
しかもカメラだけ見ていればいいわけではない。
自分の位置。敵との距離。周囲の地形。HP。スタミナ。ポーンの状態。
さらに敵が攻撃モーションに入ったら「これは攻撃が来る」と判断し、「今は攻撃をやめる」「回避する」「距離を取る」といった行動に切り替えなければならない。
そして回避が終わったら、また敵を探して攻撃に戻る。
私たちはこれをほとんど無意識でやっている。
考えてみれば、かなりおかしい。
人間はゲーム中、いったい何個の処理をしているのか
例えばドレイクが腕を振り上げたとする。
人間はそれを見た瞬間に「攻撃が来る」と認識する。でも実際には、その一瞬の中で多くのことをやっている。
敵の姿勢を見る。過去の経験から攻撃モーションだと判断する。攻撃範囲を予測する。自分との距離を確認する。
今出している攻撃を継続するか中断するか判断し、回避方向を決める。回避後に敵がどこへ移動するかも、なんとなく予測する。
それをやりながらカメラも操作している。さらに画面の隅ではHPやスタミナも見ているし、場合によってはポーンが倒れていないかも確認している。
でもゲームを遊んでいる本人には、
「敵が殴ってきたから避けた」
くらいの感覚しかない。
人間は大量の処理をしているのに、自分ではその処理の大半を意識していない。ここが一番面白かった。
じゃあAIなら、どう作る?
もちろん、AIにゲームをさせること自体は不可能ではないと思う。
ただしChatGPTのようなAIに、
「スクリーンショットを見て、次の操作を決めて」
と毎回聞いていたのでは遅すぎる。
ドレイクは待ってくれない。
ここで現在のAIにとって大きな壁になるのが、遅延だ。
Artificial Analysisの2026年9月時点の計測では、GPT-6 Astraのmedium設定は、OpenAI APIへのリクエストから最初のトークンが返るまで3.82秒となっている。
もちろん、これはテキストAPIを測定したベンチマークで、ゲーム映像から敵を認識して操作する場合の速度を直接測った数字ではない。
それでも、数秒単位で「見て、考えて、答える」を繰り返す方式では、リアルタイムのアクションゲームが厳しいことは想像できる。
ただし、ここには一つ大きな注意点がある。
私たちがChatGPTやAPI経由で使うAstraは、クラウド上のモデルにデータを送り、そこから応答を受け取り、必要ならツールやOSを経由して実際の操作につなげる。
つまり、私たちが体感する遅延のすべてが「Astraそのものが考えている時間」とは限らない。
実際、OpenAIが公開しているPlaycoの事例では、AstraをUnityやGodotなどのゲームエンジンに直接接続し、シーン編集だけでなくゲームをプレイしてテストし、変更を検証するところまで行わせている。
ただしこれはゲーム開発・テスト用途の事例だ。低遅延の映像入力と操作系を接続して、『ドラゴンズドグマ2』のような高速なアクションゲームをリアルタイムに戦わせた場合にどこまで動けるのかは、これだけでは分からない。
もしかすると、今私たちが見ているAIの限界の一部は、知能そのものではなく、AIに与えられた「身体」の限界なのかもしれない。
とはいえ、私たちが実際に作れる環境でドグマをプレイさせるなら、この遅延は無視できない。
そこで、全部をAIに考えさせるのではなく、処理を分ける。
例えば敵の位置を追跡する処理は、PC上で動く画像認識に任せる。敵が画面中央からずれたら、自動的にカメラを補正する。
これはLLMに毎回考えさせる必要はない。
回避や攻撃も同じだ。「右へ回避する」「敵に近づく」「弱攻撃を3回出す」といった基本動作を、あらかじめ関数として作っておく。
そうするとAI本体が考えるのは、
「今、何をするべきか」
だけでよくなる。
私はこれを考えているうちに、「反射」「行動」「思考」の3層に分ければいいんじゃないかと思った。
敵をカメラ中央に捉え続けたり、危険に即座に反応したりする処理は「反射」。
回避や攻撃といった定型動作は「行動」。
そして「今は攻撃するべきか」「回復するべきか」「距離を取るべきか」を決めるのが「思考」だ。
妙に生き物っぽい構造になる。