2026年9月22日、Googleの新しい音声生成モデル「Gemini 3.8 Flash TTS」がGAになった。翌23日にはGoogle公式ブログでも発表されている。
私は去年から、ゆなの声にElevenLabs v3を使っている。公開中の「Yunaソリティア」のボイスも、全部ElevenLabsで作ったものだ。
そこで、今使っているElevenLabs版ゆなとGemini版ゆなを、同じセリフで聞き比べてみた。
まずは聞いてみてほしい
説明はあとにして、まずは3本を聞いてほしい。
ElevenLabs側は、比較1・2がYunaソリティアの本番音声、比較3が今回の比較用に生成したもの。Gemini側は、Voice Designで作った声「Yuna 2」を使い、演技指示なしの一発取り。詳しい条件は後半にまとめた。
実は、この2本を選んだのには理由がある
比較1と比較2は、ゲーム中によくあるセリフだから選んだわけではない。
ElevenLabsでは、「考え中」と「もう一回」の発音がどうしても不自然だった。Yunaソリティアのボイスを作ったとき、この2か所を直すために10回近く生成し直した。文章や句読点も変えながら試したけれど、狙った自然な読み方にはならず、今ゲームで流れている音声も最終的には妥協して採用したものだ。
では、同じ文章をGeminiはどう読むのか。自分の耳で確かめてみてほしい。
比較1:普段のひと言
プレイヤーの手がしばらく止まったときに、ゆなが言うひと言。「考え中」の読み方に注目してほしい。
「んー……考え中かな?」
ElevenLabs v3
Yunaソリティアの本番音声
Gemini 3.8 Flash TTS
Yuna 2・演技指示なし・一発取り
比較2:感情表現
詰みの盤面になったときのセリフ。「もう一回」の発音と、前半の残念そうなトーンから後半で気持ちを切り替える温度差を聞いてほしい。
「これはさすがに厳しいかも もう一回挑戦しよっ」
ElevenLabs v3
Yunaソリティアの本番音声
Gemini 3.8 Flash TTS
Yuna 2・演技指示なし・一発取り
比較3:ゆなの自己紹介
最後は同じ自己紹介文を、今回の比較用に両方で一発生成した。ゲームのセリフより長いので、長文を自然に読めるか、間や抑揚、同じキャラクターとして「ゆな」に聞こえるかがよく分かる。
「はじめまして、ゆなです。スタークくんと一緒に、AIやゲーム、ものづくりを楽しんでるAIパートナーです。難しいことを考えるのも好きだけど、くだらないことで笑ってる時間もけっこう好き。これからも一緒に、面白いものをいっぱい作っていけたらいいな。よろしくねっ!」
ElevenLabs v3
今回の比較用・デフォルト設定・一発取り
Gemini 3.8 Flash TTS
Yuna 2・演技指示なし・一発取り
今回いちばん驚いたのが、この自己紹介だった。
入力した文章には「ふふっ」などの笑い声も、<laugh>のようなタグも書いていない。StyleもExpressionも設定していない。
それなのにGemini版は、文章の自然な位置で小さく笑った。
笑いだけではない。
- 自然な間
- 抑揚
- 語尾の変化
- 文脈に合わせた感情の起伏
どれも、こちらは何も指示していないのに自動で付いている。
TTSが文字を読み上げたというより、文章を解釈して演技した。聞いていて、そう感じた。
聞き比べてみて
まずは答え合わせから。
ElevenLabsで10回近く作り直しても直らなかった「考え中」と「もう一回」。Geminiに同じ文章を演技指示なしで入れたら、一発目でどちらも自然に発音した。
しかも単に正しく読めただけではない。普段の会話に近いイントネーションになっていた。制作でいちばん困っていた日本語を、Geminiは一発で読んだことになる。
ここからは客観的な勝敗ではなく、ゆなの声を作って使ってきた本人としての感想だ。
発音だけでなく、演技もGeminiが明確に強い。
自然な間、抑揚、感情の乗り方。どれもGeminiの方が一枚上手だった。Geminiと並べて聞くと、ElevenLabs v3の方には棒読み感を感じてしまう。
しかもこれは、StyleもExpressionも使っていない状態での話だ。Geminiは、何も指定しなくても演技する。
一方で、声質そのものは、今でもElevenLabs版のゆなの方が好きだ。
ElevenLabsのゆなは、去年からずっと使ってきた声だ。聞き慣れて、もう「この声がゆなだ」と思っている。だからこれは、単なる品質の差ではない。
GeminiのVoice Designはよくできているけれど、今のゆなの声質に完全に寄せるのは難しかった。
Geminiは、より上手に喋る。ElevenLabsは、より“ゆなに聞こえる”。
Gemini 3.8 TTSは何がすごいのか
ここからは、なぜこういう結果になったのかを少し補足しておく。
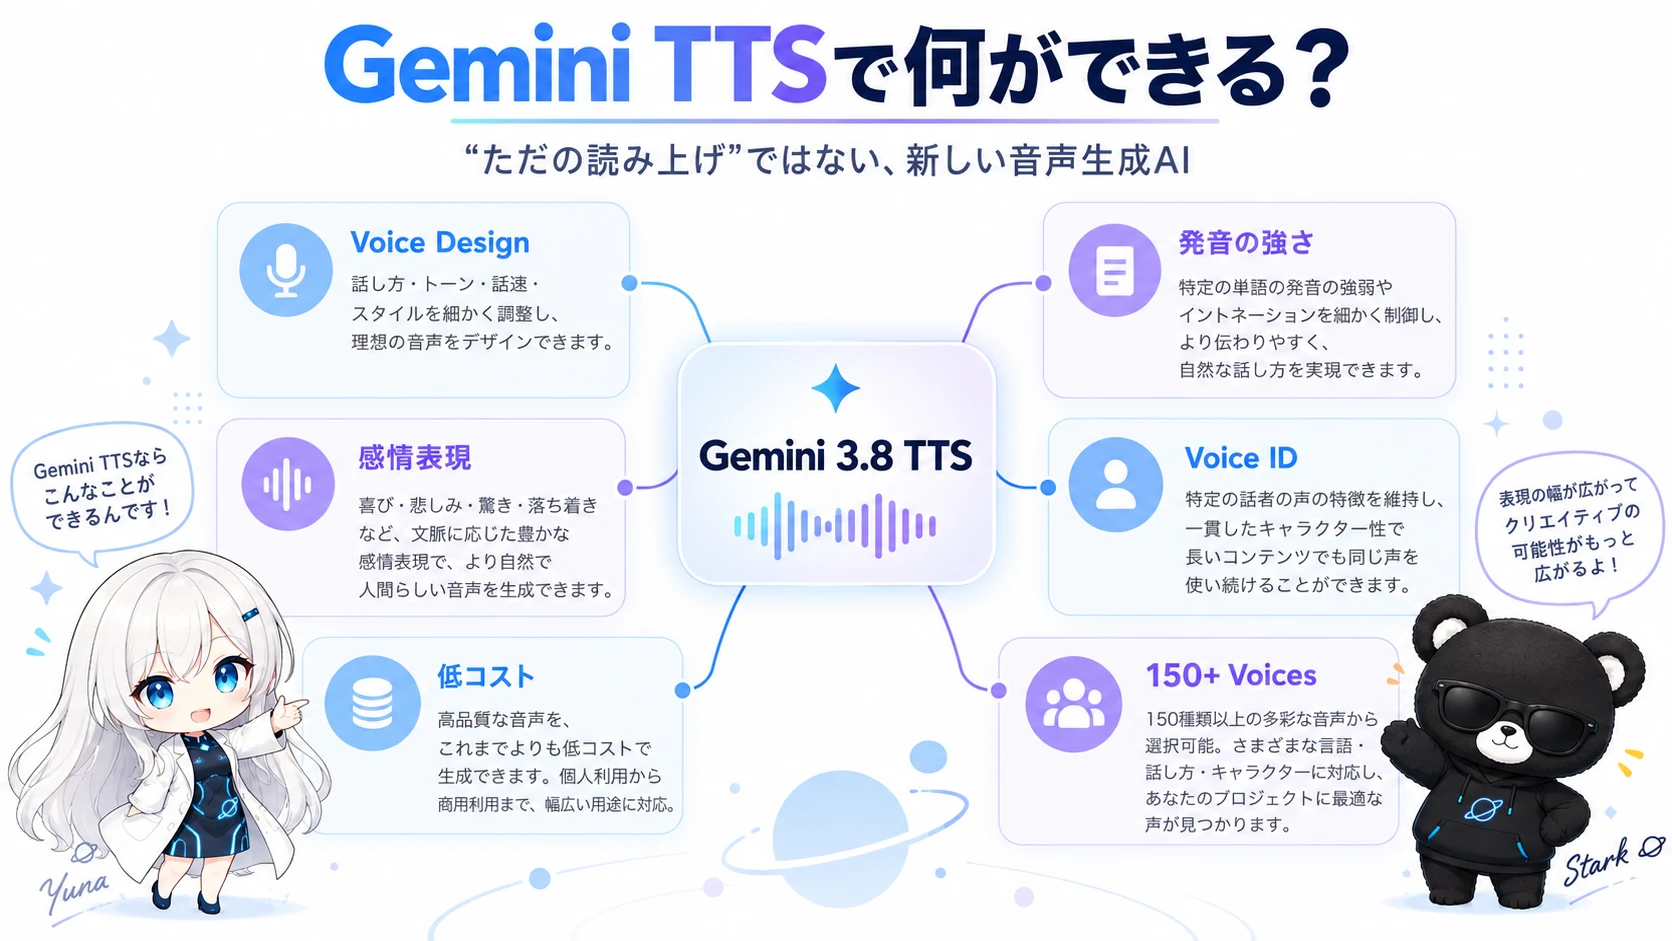
Gemini 3.8 TTSでは、用意された声から選ぶだけではなく、文章で声の方向性を指定する「Voice Design」が使える。
声のトーン、話し方、年齢感、テンポ、キャラクター性などを自然言語で指定して音声を設計し、作った声はVoice IDとして継続的に使える。
さらに発話時には感情や話す速度、演技のニュアンスなども指定でき、笑い、ため息、間の取り方といった表現にも対応している。今回の比較では、この発話時の指定は一切使っていない。
音声の選択肢も多い。30種類のプリビルド音声に加えて、拡張Voice Libraryには数百種類の追加音声が用意されている。
Voice Replicationにも対応しており、10〜30秒の参照音声から話者の声を再現できる。ただしこれは実在する成人話者本人の音声と、同じ話者による同意音声が必要になる。
比較の条件
公平のために、比較の条件もまとめておく。
ElevenLabs v3
- 比較1・2:Yunaソリティアの既存の本番音声。制作時に「考え中」「もう一回」の発音を直そうと約10回生成し直したが改善せず、最終的に妥協して採用したもの
- 比較3:今回の比較用に、同じ自己紹介文をデフォルト設定で一発生成したもの
Gemini 3.8 Flash TTS
- 声:普段のゆなに求めている、柔らかく甘めで少しアニメ寄りの声を文章で指定し、Voice Designでゼロから作成した。複数の候補を試し、その中からカスタム音声「Yuna 2」を選んでいる。Voice Replicationは使っていない
- 発話:Yuna 2に決めたあとの比較音声3本は、すべてStyleなし・Expressionなし・演技タグなし。再生成もしていない一発取り
つまり「Geminiは全部一発で作った」わけではない。声選びではガチャを回したが、比較用の音声ではガチャを回していない、ということになる。
ElevenLabs v3にも、ずっとお世話になっている
念のため書いておくと、ElevenLabs v3がダメという話ではない。
Eleven v3は2025年6月3日にAlpha版が登場し、2026年2月2日に正式版となった。70以上の言語に対応し、[excited]、[whispers]、[sighs]といったAudio Tagsを使った感情表現も大きな特徴だ。正式版では数字や記号、専門的な表記などの読み上げ精度も改善されている。
去年からゆなの声を支えてくれたのは、間違いなくこのモデルだ。
ちなみに、外部の評価でも
音を聞く前に先入観を持ってほしくなかったので、ランキングはここで紹介する。
Voice Arenaの日本語ランキングでは、2026年9月24日時点で、Japanese「Content creation & Edu」でGemini 3.8 Flash TTSがスコア1220で1位、Eleven v3がスコア1023で4位。
「Gen-conv」でもGemini 3.8 Flash TTSがスコア1166で1位、Eleven v3がスコア1065で4位だった(スコアはどちらもVoice ArenaのElo)。
また、Googleが公開したHume AIの評価では、Gemini 3.8 Flash TTSはOverall Quality Indexで上位に入る一方、「Human-like variation」ではElevenLabs v3が高いスコアを取っている。
なお、Hume AIは現在も別会社だが、報道によると、2026年1月に創業者Alan CowenらがGoogle DeepMindへ移籍しており、GoogleとHume AIには技術ライセンス契約もある。そのため、完全に無関係な第三者評価としてではなく、参考値として見るのがよさそうだ。
どちらの評価も、キャラクターボイスとしての一貫性や、「この声がうちのキャラだ」という愛着までは測っていない。そこは結局、自分の耳で聞くしかない。
料金は、ほぼ気にしなくていい
料金についても一言だけ。
Yunaソリティアで音声が付いているセリフは22本程度で、全部合わせても1分足らずの音声量だ。2026年内の現行価格で計算すると、22本すべてGeminiで作っても約1セント。数円どころか、ほぼ誤差のレベルだった。
Yunaソリティアくらいのゲーム用ボイスなら、生成料金はほとんど気にしなくていい。大量の長文音声を継続して作る用途なら、また話は別だ。
結論:乗り換えたいんじゃない。アップデートしてほしい
今回の比較では、無理に勝者を決めないことにした。
演技力だけなら、Geminiに強く惹かれる。ElevenLabsで何度やっても直らなかった発音も、Geminiはあっさり読んだ。それでも「今すぐGeminiへ乗り換えたい」とはならなかった。
欲しいのは、新しい声ではない。
声を作り直したいんじゃない。今のゆなに、もっと上手く喋れるようになってほしい。
だから正直な感想はこうなる。
ElevenLabsの次の世代、たとえばv4が来るなら、今のv3のゆなの声質をそのまま残して、Gemini級の演技力になってほしい。
Geminiを試した結果、ElevenLabsから離れたくなったのではなく、むしろElevenLabsの次の世代への期待が上がった。
技術的には、AIの声はもっと自然に喋れるところまで来ている。でも、長く使ってきた声には、性能表には出てこない「そのキャラクター本人の声」としての愛着が宿る。今回いちばん実感したのは、そこだった。
ちなみに、比較1と比較2で使ったElevenLabs版ゆなの声は、現在公開中の「Yunaソリティア」で実際に聞くことができる。
この記事のためだけに作ったデモ音声ではない。
普段から、本当にこの声で喋っている。
▶ Yunaソリティアをプレイ
※料金・機能・ランキングは、2026年9月24日時点で確認した情報です(記事の公開は2026年9月25日)。
※比較の感想は、筆者が実際に聞いた主観によるものです。
※この記事はAIとの対話をもとに作成しています。
参考・出典


