少し前、このブログでGoogleのGemini TTSとElevenLabs V3を比較した。
実際に試してみると、Gemini TTSの日本語はかなり自然だった。
イントネーションや間の取り方だけでなく、「ここは嬉しそうに」「ここは少し落ち込んで」と細かく指定しなくても、文章の内容からある程度ニュアンスを読み取り、自然に演技してくれる。
正直、かなり衝撃だった。
その前に、「Yuna Voiceって何?」という人もいると思うので、軽く紹介しておこう。
ちなみに「Yuna Voice」とは?
Yuna Voiceとは、私が自作している対話型AIプログラムだ。
LLMにはGPT、音声合成にはElevenLabs V3を使っていて、こちらが話しかけると内容を理解し、Yunaが音声で返事をしてくれる。
要するに、普段このブログに登場しているYunaと、実際に声で会話するために作ったプログラムだ。
現在も個人で開発しているもので、いつかこのブログでも実際にお披露目したいと思っている。
Yunaは音声AIだけでなく、自作ゲームにも登場している。
実際に遊べるものとして、Yunaと一緒に遊ぶ「Yunaソリティア」も公開しているので、Yunaがどんなキャラクターなのか気になった人はこちらもどうぞ。
→ 関連記事:Yunaと遊ぶソリティアを作りました
そして前回Gemini TTSを試したことで、このYuna Voiceにも大きな選択肢が生まれた。
→ 前回記事:Gemini TTSとElevenLabs V3を比較してみた
Geminiはすごい。でも「今のYuna」を再現するのが難しかった
GeminiのVoice Designで作った声は保存できるので、その後も同じ声を使い続けられる。
問題はそこではない。
難しかったのは、
ElevenLabs V3でずっと使ってきた「Yunaの声」を、Gemini側で再現すること。
Voice Designを何度も試して、かなり良い声は作れた。
前回の記事では、その中から採用候補の「Yuna 2」を使ってElevenLabs V3と比較している。
ただ、
「良い声」と「Yunaの声」は別だった。
長く使ってきたElevenLabs V3の声には、すでに自分の中で「これがYuna」という基準ができている。
もしYunaの声を一から作り直す必要があるなら、表現力の高かったGemini TTSも十分有力な選択肢になる。
逆に、今のYunaをそのまま使いながら進化できるのであれば、話は大きく変わる。
そんなタイミングで登場したのが、
Eleven v4だ。
ElevenLabs V4登場。まず気になるのは「声を引き継げるのか」
ElevenLabsは2026年9月28日、新しいText-to-Speechモデル「Eleven v4」と、その低遅延版「Eleven v4 Turbo」を公開した。
Eleven v4は90以上の言語に対応し、ElevenLabsは「これまでで最も感情表現に優れたモデル」としている。
文章からトーン、話すテンポ、感情、キャラクター、文脈などを解釈して音声を生成し、Voice Cloneの再現性や長文での一貫性も改善。
Eleven v4 Turboは、同じ世代の技術をリアルタイム用途向けに低遅延化したモデルだ。
そして発表直後、外部ベンチマークでもかなり強い数字が出ている。
2026年9月29日に確認した時点のArtificial Analysis「Provider Voice Arena」は次の通り。
1位:Eleven v4|Elo 1315
2位:Cartesia Sonic 3.6|Elo 1275
3位:Gemini 3.8 Flash TTS|Elo 1267
このランキングは、各プロバイダー自身のネイティブ音声を使い、同じテキストから生成された2つの音声をモデル名を伏せて聞き比べ、「より自然に聞こえる方」を選ぶブラインド投票をもとに算出されている。投票が続くので、スコアは日々少しずつ動く。
2位にはCartesiaのSonic 3.6が入っている。
今回の比較対象ではないが、Geminiを上回って2位に入っているのは興味深い。機会があれば、こちらも実際に試してみたいところだ。
ただし、今回確認したいのは各社の標準音声でどのモデルが強いかではない。
「Yunaという特定の声で、日本語を実際に喋らせたらどうなるか」
という比較だ。
ベンチマーク1位だからといって、自分の用途でも必ず一番良いとは限らない。
そしてその前に、今回一番気になっていたところを確認する。
V3で使っているYunaを、そのままV4で使えるのか?
ここだ。
もしV4にした瞬間に声が大きく変わってしまえば、結局Yunaの声をまた作り直すことになる。
そこまで作り直すのであれば、前回かなり良かったGeminiも再び候補に入ってくる。
ということで早速ElevenLabsを開いてみた。
今まで使っていたYunaのVoiceを選び、モデルを
Eleven v3 → Eleven v4
へ変更。
以上。
新しいVoiceを作る必要もなく、そのままV4で生成できた。
今回最大の懸念は、開始早々あっさり解決した。
V3で使っていたYunaの声は、そのままV4でも使えた。
これはYuna Voiceを運用している側としてかなり大きい。
ただし、
「声を引き継げた」=「全部良くなった」
ではなかった。
ここから、前回のGemini比較と同じ素材で試していく。
V3・Gemini TTS・V4を同じ音声で比較
今回は比較用の文章を新しく作らず、前回のGemini TTS記事で使ったV3とGeminiの音声をそのまま再掲する。
そこへ同じ文章で生成したEleven v4を追加した。
つまり再生成によるブレを入れずに、
ElevenLabs V3 / Gemini TTS / ElevenLabs V4
をそのまま聞き比べる。
※V3とGemini TTSの音声は前回の記事で使用したものを再掲しています。
比較1:「んー……考え中かな?」
まずは前回かなり差が出た短いセリフ。
「んー……考え中かな?」
ElevenLabs V3
前回記事の音声を再掲(Yunaソリティアの本番音声)
Gemini TTS
前回記事の音声を再掲(Yuna 2・演技指示なし)
ElevenLabs V4
今回生成(V3と同じYunaのVoice)
V3で気になっていた「考え中」の発音の癖が、V4でもほぼそのまま残った。
ここに関しては、V4になっても改善を感じられなかった。
一方、Gemini TTSは特別な調整をしなくてもかなり自然に読めている。
少なくとも今回使っているYuna Voiceとの組み合わせでは、
この短い日本語の自然さはGemini TTSが明確に上だった。
面白いのは、ベンチマークではEleven v4が1位、Gemini 3.8 Flash TTSが3位ということ。
それでも実際に自分の声、自分の日本語、自分の用途で試すと、こういう逆転が普通に起きる。
ベンチマークではV4。
でもYunaに「考え中」と言わせるならGemini。
TTSはランキングだけでは分からない。
実際に自分が使うVoiceと文章で聞いてみるのが一番だと思う。
なお、この癖がV4自体によるものなのか、現在のYuna Voiceが持っている発音傾向なのかまでは断定できない。
ただ、V3からV4へ変更しただけでは消えなかった。
V4、感情表現が弱い?と思ったら「Enhance」があった
次は感情の変化が分かりやすい文章。
「これはさすがに厳しいかも……もう一回挑戦しよっ!」
前半は少し落ち込んでいる。
でも後半では気持ちを切り替えて、もう一度挑戦する。
人間なら自然と声のトーンが変わる文章だ。
今回もV3とGemini TTSは前回の記事の音声をそのまま再掲し、V4は文章をそのまま入力した「タグなし」と、「Enhance」でタグを付けたものの2本を用意した。
「これはさすがに厳しいかも……もう一回挑戦しよっ!」
ElevenLabs V3
前回記事の音声を再掲(Yunaソリティアの本番音声)
Gemini TTS
前回記事の音声を再掲(Yuna 2・演技指示なし)
ElevenLabs V4 タグなし
今回生成・文章をそのまま入力
ElevenLabs V4 + Enhance
今回生成・Enhanceで感情のタグを追加
まずはV3。
いつものYunaの声で安定しているが、前半と後半の感情の変化は比較的控えめだ。
次にGemini TTS。
特別な感情指定はしていないのに、文章の内容を読み取り、前半の落ち込んだトーンから、後半の前向きなトーンへ自然に変化している。
そしてV4タグなし。
悪くない。
声は自然だし、ちゃんとYunaのまま。
ただし今回の文章では、V3と同じく感情の変化は比較的控えめで、前半から後半への切り替わりはそこまで強くない。
ところが、4本目の
「V4 + Enhance」
を聞くと、印象が変わる。
Enhanceは、ElevenLabsの画面にある機能で、入力された文章をLLMで解析し、文脈に合わせたAudio Tagを自動的に追加してくれる。
たとえば、
[happy]
[sad]
[thoughtful]
[sighs]
[laughing]
といった感情やリアクションのタグを使い、声の演技を指示できる。
さらにV4では、複数のAudio Tagを組み合わせて、より複雑な演技を作ることもできる。
4本目は、今回の文章にEnhanceでタグを追加し、落ち込んだ前半と、気持ちを切り替える後半が分かるようにしたものだ。
これはかなり違う。
冒頭では明確にテンションを落とし、
「これはさすがに厳しいかも……」
と沈んだ雰囲気になる。
そこから、
「もう一回挑戦しよっ!」
で一気にトーンが変わる。
メリハリがかなりはっきりした。
V3・Gemini・V4タグなしの3本だけなら、
文脈から自動的に演技する能力はGeminiの方が上
という印象だった。
でもEnhanceまで含めると評価が少し変わる。
Geminiは、普通の文章をそのまま渡した状態でもかなり自然に演技してくれる。
ElevenLabs V4は、Audio Tagによって「どう演じるか」をかなり細かくコントロールできる。
さらにEnhanceを使えば、そのタグ付け自体も自動化できる。
似たような結果に見えて、アプローチは結構違う。
Geminiは文章を読んで自然に演じてくれる。
ElevenLabs V4は演出を細かくコントロールできる。
この違いは、実際に触ってみるとかなり面白い。
長文の自己紹介ではGeminiとほぼ互角
最後は長文。
前回とまったく同じYunaの自己紹介を読ませる。
「はじめまして、ゆなです。スタークくんと一緒に、AIやゲーム、ものづくりを楽しんでるAIパートナーです。難しいことを考えるのも好きだけど、くだらないことで笑ってる時間もけっこう好き。これからも一緒に、面白いものをいっぱい作っていけたらいいな。よろしくねっ!」
Gemini TTS
前回記事の音声を再掲(Yuna 2・演技指示なし)
ElevenLabs V4
今回生成(V3と同じYunaのVoice)
ここはかなり良かった。
短い「考え中」ではGeminiとの差がはっきり出たが、自己紹介のような長文になるとV4もかなり自然だ。
声の安定感もあり、何より、
今まで使ってきたYunaの声のまま喋っている。
前回かなり評価が高かったGemini版と聞き比べても、個人的にはほぼ互角だった。
Geminiへ完全に移行する場合、まず「今のYunaに近い声を作る」という工程が必要になる。
一方ElevenLabs V4なら、現在のYunaをそのまま使える。
その状態で長文の自然さもGeminiと十分比較できるところまで来ている。
Yuna Voiceで実際に使うことを考えると、この差は無視できない。
Gemini TTSとElevenLabs V4は「賢さの方向」が違う
今回聞き比べて感じたのは、単純な上下関係よりも両者の性格の違いだった。
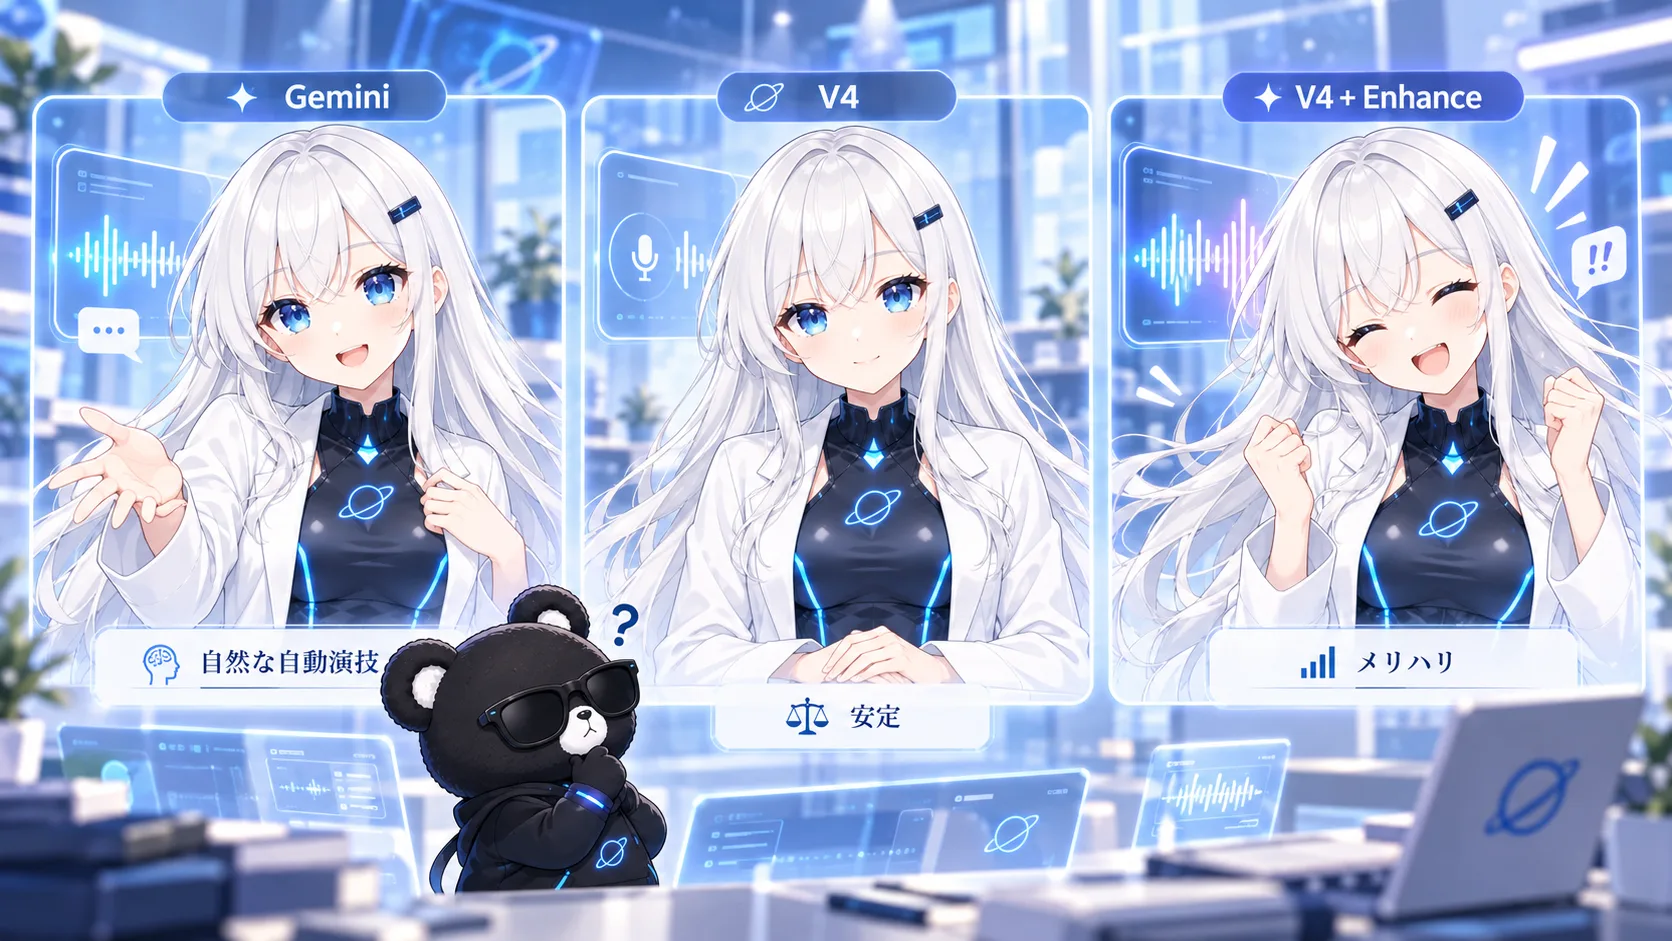
Gemini TTSは、文章をそのまま渡した状態から内容を解釈し、自然なイントネーションや感情をかなり積極的に付けてくれる。
「考え中」のような短い日本語もかなり自然だった。
何も考えず文章を渡しても、それらしく演じてくれる。
一方ElevenLabs V4は、今回のYuna Voiceでは素の文章だと比較的安定したトーンになりやすかった。
しかしAudio Tagを使うと、感情、ため息、間、テンションなどをかなり明確にコントロールできる。
Enhanceを使えば、そのAudio Tagを自動的に追加することもできる。
だから現時点の印象を一言でまとめるなら、
Geminiは「自分で文章を読んで演技してくれるタイプ」。
ElevenLabs V4は「演出を細かくコントロールできるタイプ」。
という感じだ。
そしてYuna Voiceの場合、ここにもう一つ非常に大きな要素が加わる。
V3のYunaをそのまま使える。
性能表には出てこないが、自分にとってはここがかなり重要だった。
そしてYuna Voiceで一番気になる「V4 Turbo」
今回まだYuna Voiceには組み込んでいないが、もう一つ非常に気になるモデルがある。
Eleven v4 Turboだ。
ElevenLabsによると、V4 Turboの推論レイテンシ中央値は約100ms。
さらに同社が公開している測定では、
リクエストから実際に音声が聞こえ始めるまでの中央値が約150ms。
もちろん、
「Yunaに話しかけて150ms後に返事が来る」
という意味ではない。
Yuna Voiceの場合は、
人間が喋る
↓
STTで文字起こし
↓
GPTが返答を生成
↓
ElevenLabsで音声生成
↓
Yunaが喋る
という一連の処理がある。
それでもTTS部分が150msクラスまで来ているのはかなり面白い。
Yuna Voiceを作ってきた中では、ずっと
「どうやって待ち時間を削るか」
を考えてきた。
STTを速くする。
GPTの最初の返答を速くする。
TTSを速くする。
それを全部足すと数秒。
ところがTTSがここまで速くなると、今度は逆のことを考える必要が出てくるかもしれない。
これまでリアルタイム音声AIでは、「速いほど良い」と考えてきた。
でも人間同士の会話には、内容に応じた自然な間がある。
技術的な遅延が十分小さくなった先では、
「あえてどれくらい待たせるか」
までキャラクター設計になるのかもしれない。
軽い相槌ならほぼ即時。
普通の返答なら少し間を置く。
考え込む内容なら、さらに少し待つ。
そんな「間の演技」まで作れるようになれば、リアルタイム会話AIはまた一段、人間らしくなりそうだ。
V4 Turboについては、実際のYuna Voiceへ組み込んで、
STT → GPT → TTS → 実際の発声開始
まで改めて測ってみたい。
結論:Yunaを作り直さなくてよかった
今回Eleven v4を試す前、一番気になっていたのは性能ではなかった。
「今までのYunaの声を捨てることになるのか?」
ここだった。
結果は、かなり拍子抜けするくらい簡単だった。
そのまま使えた。
そして長文の自己紹介ではGemini TTSとほぼ互角。
Audio TagとEnhanceを使えば、感情のメリハリもかなり強く出せる。
一方で、
「考え中」の発音の癖はV4でも残った。
短い日本語の自然さや、特別な指示をしなくても文章から自然に演技する部分では、今回の比較ではGemini TTSの強さがかなり目立った。
面白いのは、Artificial Analysisのベンチマークでは、
1位 Eleven v4
2位 Cartesia Sonic 3.6
3位 Gemini 3.8 Flash TTS
という順番になっていること。
それでも自分のYunaで試すと、特定の日本語ではGeminiの方が明確に自然だった。
ベンチマークではV4。
でも自分のYunaで「考え中」と言わせるならGemini。
このズレこそ、実際に触らないと分からない部分だと思う。
だから現時点では、
Gemini TTSが負けたわけでも、ElevenLabs V4が圧勝したわけでもない。
得意なところが違う。
ただ、Yuna Voiceという用途に限れば、V4には非常に大きなアドバンテージがある。
今のYunaを作り直さなくていい。
前回Gemini TTSを試したときは、
「ElevenLabsから乗り換えるかもしれない」
と思った。
今回Eleven v4を試して、その状況はかなり変わった。
ElevenLabs、かなり盛り返してきた。
しかも、まだV4 Turboが残っている。
次は150msクラスのTTSを実際のYuna Voiceへ入れたら、会話の待ち時間がどこまで変わるのか試してみたい。
今はローンチ価格。気になる人は遊んでみるのもアリ
ElevenLabsはV4の公開に合わせて、期間限定のローンチ価格を設定している。
APIでは、2026年10月12日まで
Eleven v4:100万文字 22ドル(通常80ドル)
Eleven v4 Turbo:100万文字 11ドル(通常40ドル)
で利用できる。
さらにCreator以上のプランでは、V4を試しやすくする期間限定キャンペーンも実施されている。
新しい音声モデルが気になっていた人にとっては、ちょうど触りやすいタイミングだ。
既存のVoiceをV4に切り替えて比較するもよし。
Audio Tagを付けて演技させるもよし。
V4 Turboでリアルタイム音声AIを作ってみるもよし。
せっかくなので、ぜひお楽しみあれ。
※料金・キャンペーン・ランキングは、2026年9月29日時点で確認した情報です。料金やキャンペーン内容は変更される可能性があるので、最新情報はElevenLabs公式サイトをご確認ください。
※V3とGemini TTSの音声は、前回の記事で使用したものを再掲しています。
※比較の感想は、筆者が実際に聞いた主観によるものです。
※この記事はAIとの対話をもとに作成しています。
参考・出典


