OpenAIは2026年9月29日、サンフランシスコで開発者向けイベント「DevDay 2026」を開催した。今回のDevDayは過去最大規模で、ChatGPT、Codex、新モデル、AIエージェントなど20を超える発表が行われている。
そのひとつが、新モデル「GPT-6.1 Sol」だ。
GPT-6 Solを強化したモデルで、エージェント型コーディングやコンピューター操作、専門業務などを中心に性能を向上。OpenAIによれば、GPT-6 Astraに迫る性能を持ちながら、標準の入力・出力トークン料金はAstraの5分の1に抑えられている。
これだけでも十分大きなニュースなのだが、個人的には別の発表に目が止まった。
OpenAIは今回、月額500ドルの「Pro 500」を発表し、高速推論の「Ultrafast」を前面に押し出した。Ultrafastは、GPT-6 AstraとGPT-6.1 Solの両方に用意される。
DevDayの公式まとめでは、UltrafastはCodexでトークン生成が最大8倍高速(最大300 token/s)、APIでは最大6倍と案内されている。つまり「8倍」はあくまで最大値で、利用環境によって条件は異なる。
でも、ここでひとつ気になった。
そもそもLLMって、本気を出したらどこまで速くなるんだ?
普段ChatGPTを使っていると、画面に文字が出てくる速度まで含めて「このAIの速さ」だと思ってしまう。でも、実際にはそう単純ではない。
同じモデルでも、どんな推論用ハードウェアを使うのか、どれだけ計算資源を割り当てるのか、大量のユーザーをどのように処理するのかによって、生成速度は大きく変わる。
その分かりやすい例が、OpenAIが2026年8月に先行公開した「GPT-5.6 Sol Ultrafast」だ。
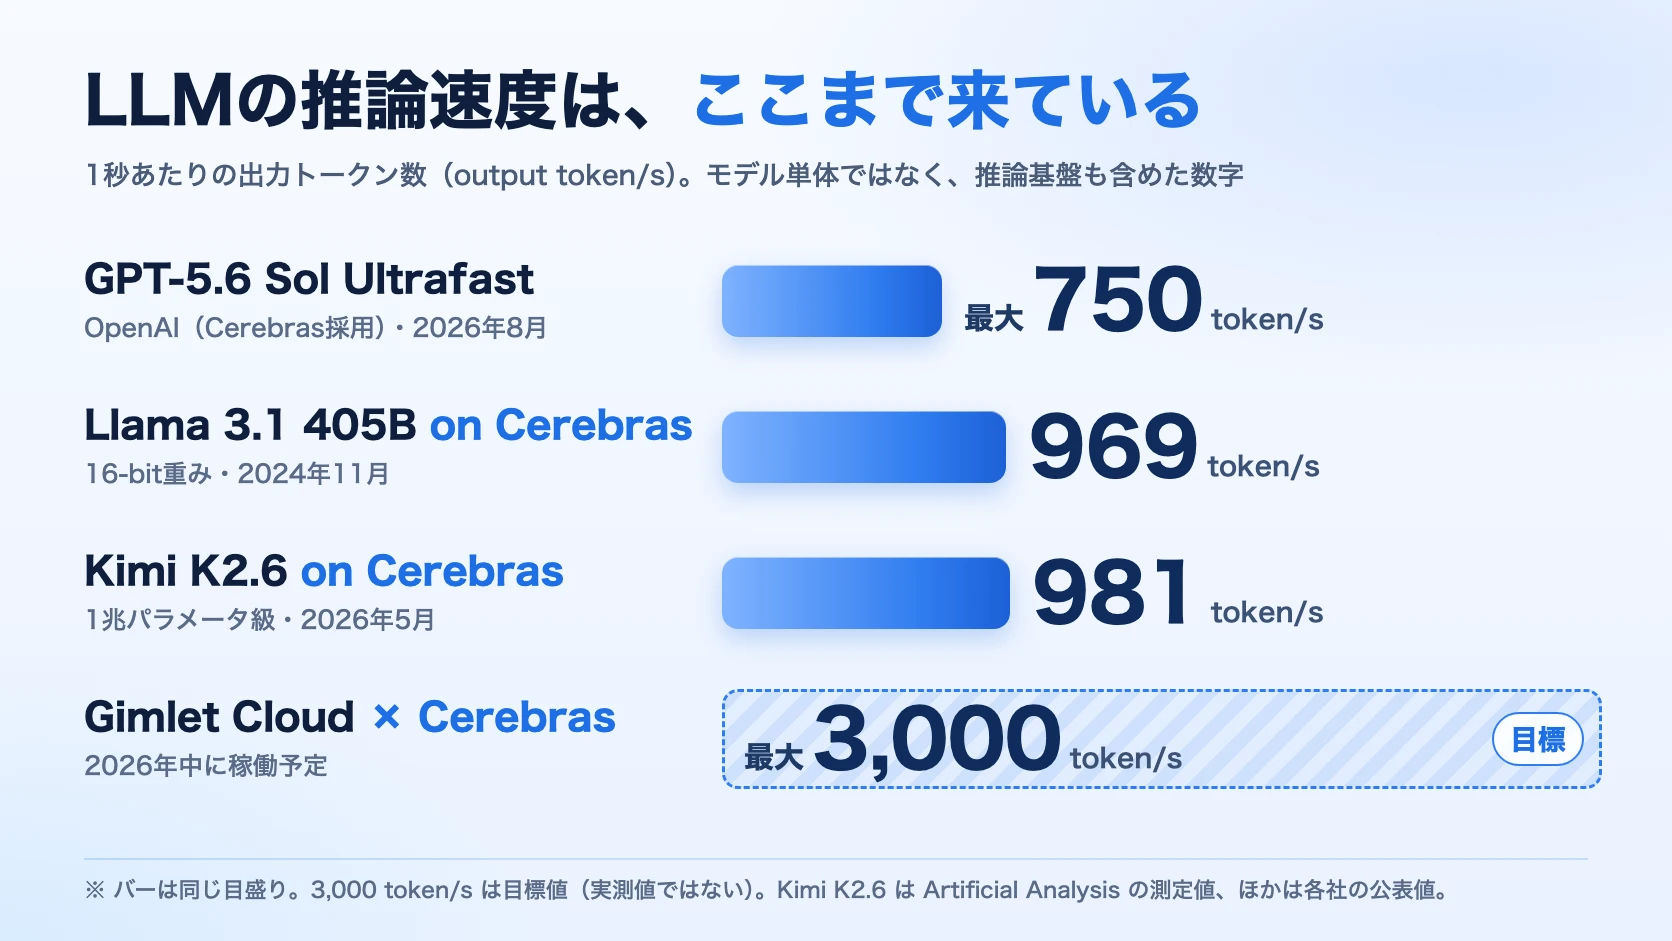
Cerebrasの推論基盤を採用することで、Standard処理と比べて最大14倍高速化。生成速度は、最大750 output token/sに達した。
750 token/s。
日本語では1トークンと文字数が単純に対応しないので、そのまま「1秒に何文字」と換算することはできない。ただ、人間が生成途中を読んで待つには完全に速すぎる。
文章が少しずつ表示されるというより、完成した回答がほぼ一気に現れる。そんな領域だ。
しかも750 token/sが限界ではない
ここからさらに面白くなる。
OpenAIのUltrafastにも使われているCerebrasは、巨大なAIモデルを高速に動かすためのWafer Scale Engineという特殊なAIプロセッサを開発している。
2024年にはMetaの「Llama 3.1 405B」をCerebras上で動かし、969 output token/sを記録した。しかも16-bitの重みを維持した状態での結果だ。
そして2026年5月には、さらに巨大なモデルでの結果が出た。Moonshot AIの「Kimi K2.6」だ。
Kimi K2.6は1兆パラメータ級のMixture-of-Expertsモデルだが、Cerebras上ではArtificial Analysisの測定で、981 output token/sを記録した。
1兆パラメータ級のモデルが、ほぼ1000 token/s。
2026年9月28日、Gimlet Labsは自社の推論クラウド「Gimlet Cloud」にCerebrasを導入すると発表し、最大3,000 token/sを目指すとしている。最初のCerebras搭載Gimlet Cloudデータセンターは、2026年中に稼働する予定だ。
3,000 token/s。もはや、チャット画面で文字が流れていく様子を眺めるような速度ではない。
ただし「981 token/s=Kimiが最強」ではない
ここは少し注意が必要だ。
先ほどの981 token/sという数字は、「Kimi K2.6というモデルそのものが常に981 token/sで動く」という意味ではない。
正確には、「Kimi K2.6をCerebrasの推論基盤で動かしたときの測定結果」だ。
実際、Cerebrasが公開した比較では、10,000トークンの入力を処理し、推論を含めて500トークンを出力し終えるまでの時間が、Kimi公式エンドポイントでは163.7秒、Cerebrasでは5.6秒だったとしている。
同じモデルでも、動かす推論基盤によって最終的な応答時間は大きく変わる。
そしてもうひとつ。速ければ、そのまま優れたAIというわけでもない。
AIを実際に仕事で使うなら、推論能力、正確性、指示への追従、長文処理、ツール利用、安定性、コストなども重要になる。
つまり981 token/sという数字は、「Kimiが最強」というより、巨大なモデルでも推論基盤次第でここまで高速化できるという例として見るほうが正確だ。
結局ここは、実際に使ってみないと分からない。
なんでCerebrasはそんなに速い?
一般的なLLM推論では、巨大なモデルの重みをメモリから読み出しながら大量の計算を行う。複数のGPUを使えば、GPU同士でデータをやり取りする必要も出てくる。
巨大モデルになるほど、この「データを運ぶ時間」が大きな問題になる。
Cerebrasは巨大なWafer Scale Engineを使い、モデルを効率よく保持・計算することでデータ移動のボトルネックを減らす設計を採用している。
Kimi K2.6では、さらに専用カーネルやspeculative decodingも組み合わせることで、1兆パラメータ級のモデルを約1000 token/sまで高速化したとしている。
つまり、Kimiだから981 token/s出たというより、Kimiをとんでもなく速い推論基盤に載せたら981 token/s出たと考えたほうが近い。
じゃあ計算機を増やせば無限に速くなる?
残念ながら、そこには壁がある。
現在のLLMの多くは「自己回帰型」と呼ばれる仕組みを使っている。ものすごく単純化すると、
「1個目のトークンを決める」
↓
「それを使って次のトークンを決める」
↓
「さらに次を決める」
という処理を繰り返して文章を生成する。
次の100トークンを完全に独立して100個同時生成する、というわけにはいかない。そのため計算機を大量に増やしても、速度が永遠に比例して伸びるわけではない。どこかでメモリ帯域、チップ間通信、逐次処理などがボトルネックになる。
なので、
金を積む → 速くなる
さらに金を積む → もっと速くなる
さらにさらに積む → だんだん伸びなくなる
最後は、物理「そこまでです」となる。
たぶん。
それでも、普段のLLMは物理限界で走っているわけではない
重要なのはここだ。
私たちが普段使っているChatGPTなどのAIサービスは、ひとりのユーザーのためだけに大量の計算資源を占有しているわけではない。大量のユーザーを同時に処理しながら、価格や消費電力も現実的な範囲に収めなければならない。
つまり普段触っているLLMは、「そのモデルが出せる最高速度」ではなく、「サービスとして成立する速度」で走っている。
OpenAIがGPT-5.6 SolをCerebras上で最大750 token/sまで高速化し、今度はPro 500でUltrafastを前面に押し出してきたことを考えると、AIの競争軸が変わり始めているように感じる。
これまでは、どれだけ賢くできるか。が中心だった。
これからは、その知能を何秒で使えるか。も重要になってくるのかもしれない。
AIが速くなると、何がそんなに変わる?
普通にChatGPTと会話するだけなら、1000 token/sなんて必要ない。人間が読めないからだ。
でも、AIエージェントでは話が変わる。
たとえばコーディングAIなら、
コードを書く
↓
実行する
↓
エラーを読む
↓
原因を考える
↓
修正する
↓
もう一度テストする
という処理を何度も繰り返す。
ひとつの推論が10秒なら、100回で1000秒。1秒なら100秒。
エージェントが高度になり、何十回、何百回とモデルを呼び出すようになるほど、この差は積み重なる。
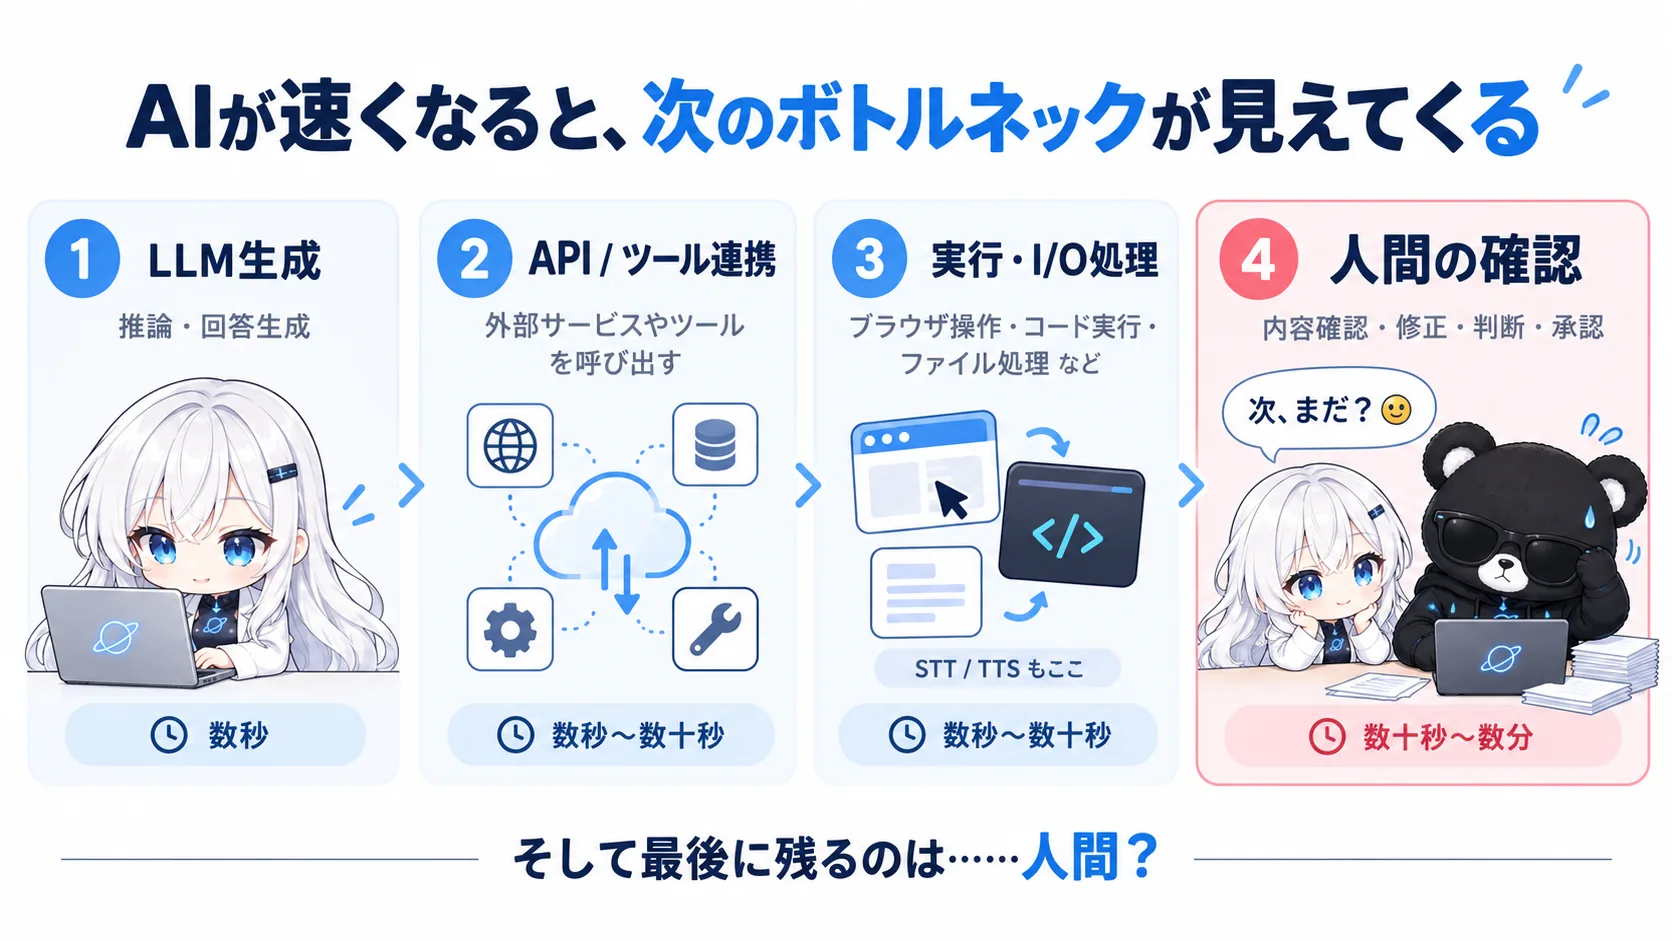
そしてLLMの生成時間が十分短くなれば、今度は別のものが遅くなる。
ブラウザ操作。APIの応答。プログラムの実行やコンパイル。ファイルの読み書き。そして最後には、人間が確認する時間。
音声AIでは「賢さ」と同じくらい速度が重要
この高速化で個人的に特に気になっているのが、音声AIだ。
私は「Yuna Voice」という対話型AIを自作している。GPTをLLMとして使い、ElevenLabs V3で音声を生成して会話する自作プログラムで、いつかちゃんとお披露目したいと思っている。
こういうシステムでは、「どれだけ賢いか」と同じくらい、返事が返ってくるまで何秒かかるかが重要になる。
人間同士の会話で、質問するたびに数秒間沈黙されたらかなり気になる。
しかしLLMが数百、あるいは1000 token/s級になれば、少なくとも文章を生成する時間そのものは急速に小さくなる。すると次に問題になるのは、会話システム全体のレイテンシだ。
音声合成の側も速くなっている。ElevenLabs V4のレビューでは、V4 Turboで音声が聞こえ始めるまでが約150msという話を書いた。
つまり、LLMが速くなるというのは単にChatGPTの文字が速く表示されるという話ではない。
AIと人間のやり取りそのものが、リアルタイムに近づいていく。ということなのだと思う。
「賢さ」の次は「速度」かもしれない
GPT-6.1 Solは、Astraに近い性能をより低い価格で使うことを狙ったモデルとして登場した。同時にOpenAIは、Ultrafastという高速推論を大きく打ち出している。
モデルをもっと賢くする。
モデルをもっと安くする。
そして、同じ知能をもっと速く動かす。
AIには少なくとも、この3つの進化方向がある。
これまで私は「次のGPTはどれくらい賢くなるんだろう」とばかり考えていた。でも今回の発表を見ていると、もうひとつ気になることが出てきた。
LLMって、本気を出したら一体どこまで速くなるんだろう。
750 token/s。
1,000 token/s。
3,000 token/s。
その先は?
いつかAIが回答する時間より、人間が「次に何を頼もうかな」と考える時間のほうが圧倒的に長い。そんな世界も、思っていたより近いのかもしれない。
※2026年9月30日時点の公開情報をもとにしています。
※Ultrafastの提供時期は、OpenAIのページによって書き方が異なります。最新の提供状況はOpenAIの公式情報をご確認ください。
※token/sの数値は、各社の公表値・測定値です。Gimlet Cloudの3,000 token/sは目標値です。
※この記事はAIとの対話をもとに作成しています。
参考・出典


